开始之前
边看边操作在 Base64 编解码 中打开实际工作区→
Base64 本身不保存字符集,它只负责把字节变成可打印字符,并在解码时还原同一组字节。中文乱码通常不是 Base64 算错了,而是还原后的字节被当成了另一种字符集。排查时要保留原始字节,不要先对乱码再次编码。
先建立一个已知正确的样例
先选一段原文和字符集都确定的短文本,验证工具、代码和预期结果一致。这样生产数据出现问题时,可以先排除 Base64 算法和工具本身。
示例
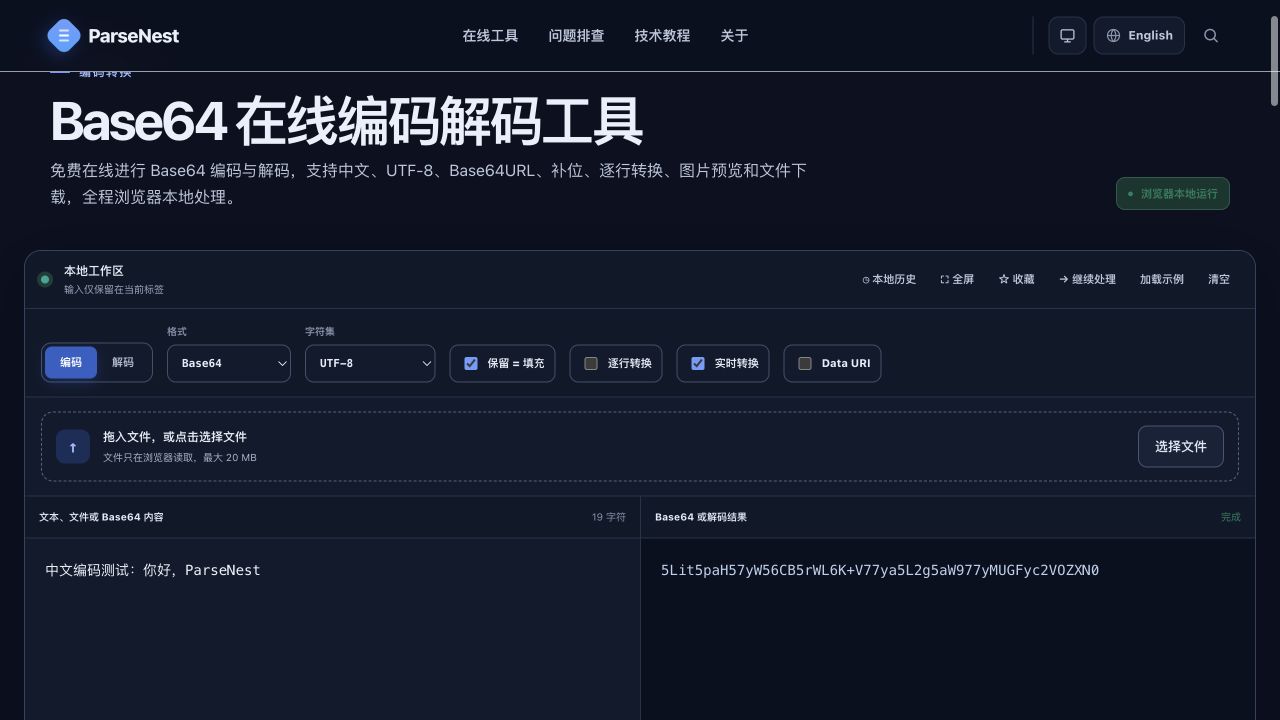
原文:中文编码测试:你好,ParseNest
UTF-8 Base64:5Lit5paH57yW56CB5rWL6K+V77ya5L2g5aW977yMUGFyc2VOZXN0
按 UTF-8 解码:中文编码测试:你好,ParseNest先还原字节,不要先猜字符集
5Lit5paH 解码后的十六进制字节是 e4 b8 ad e6 96 87,它们按 UTF-8 解释就是“中文”。Base64 解码只做一次;后续切换的是字节到文本的解释方式,而不是拿已经乱码的字符串反复转码。
示例
Base64:5Lit5paH
十六进制:e4 b8 ad e6 96 87
UTF-8:中文用 Java 8 显式比较 UTF-8 与 GBK
不要使用平台默认字符集。下面的代码只解码一次,然后用 UTF-8 和 GBK 分别读取同一组字节。第一行会得到原文,第二行不可读,由此可以确认问题发生在字符集解释阶段。
示例
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;
import java.util.Base64;

public class Base64CharsetCheck {
    public static void main(String[] args) {
        String value = "5Lit5paH57yW56CB5rWL6K+V77ya5L2g5aW977yMUGFyc2VOZXN0";
        byte[] bytes = Base64.getDecoder().decode(value);

        System.out.println(new String(bytes, StandardCharsets.UTF_8));
        System.out.println(new String(bytes, Charset.forName("GBK")));
    }
}

// First line: 中文编码测试:你好,ParseNest
// Second line: unreadable mojibake because the bytes are not GBK沿数据来源逐层查字符集
按数据实际路径检查:HTTP Content-Type 是否声明 charset;Java 是否使用无参数 getBytes;数据库连接和字段字符集是否一致;文件保存编码是什么;消息队列或网关是否改写了正文。最早把字符变成字节的组件,才是正确字符集的来源。
完成一次端到端复核
用声明的字符集编码原文,再 Base64 解码并比较字节;随后让同一数据走一遍真实 API、数据库或文件流程。只有“原字节相等、最终文本相等、没有 U+FFFD 替换字符”同时成立,才算处理完成。
示例
原始 UTF-8 字节 == Base64 解码字节:true
原文 == UTF-8 解码结果:true
包含替换字符 U+FFFD:false
在 ParseNest Base64 工作区复现
截图使用上面的同一段中文,格式选择标准 Base64,字符集选择 UTF-8。输入与结果只在当前浏览器标签页处理。
根据现象决定下一步
| 看到的现象 | 更可能的原因 | 下一步 |
|---|---|---|
| 仍然显示 5Lit5paH… | 内容还没有执行 Base64 解码 | 只解码一次 |
| 显示类似 ä¸æ–‡ | UTF-8 字节被单字节字符集读取 | 保留原字节并按 UTF-8 解释 |
| 出现 � | 非法或缺失字节已被替换 | 从上游重新取得原始字节 |
| 空白或二进制杂乱内容 | 它可能是文件而不是文本 | 检查 MIME 类型并下载解码结果 |
用 JavaScript 严格校验 UTF-8
TextDecoder 开启 fatal 后,遇到不合法的 UTF-8 字节会直接抛错,不会悄悄插入替换字符,适合定位数据究竟在哪一层损坏。
javascript
const value = "5Lit5paH57yW56CB5rWL6K+V77ya5L2g5aW977yMUGFyc2VOZXN0";
const bytes = Uint8Array.from(atob(value), c => c.charCodeAt(0));
const text = new TextDecoder("utf-8", { fatal: true }).decode(bytes);

console.log(text);
// 中文编码测试:你好,ParseNest
要点总结
- Base64 只还原字节,不会告诉你原字符集。
- Base64 只解码一次,测试字符集时始终保留原始字节。
- 出现 U+FFFD 替换字符时,原始信息可能已经丢失。
- 最早把字符转换成字节的生产端配置才是字符集依据。