开始之前
边看边操作在 Base64 编解码 中打开实际工作区→
Java 8 已经内置 java.util.Base64,不需要使用 sun.misc 或第三方库。真正需要选择的是标准、URL 还是 MIME 变体,是否保留填充,字符集是否明确,以及文件应一次读入还是流式处理。
编码和解码 UTF-8 文本
使用 StandardCharsets.UTF_8 明确完成字符与字节的转换,不要依赖操作系统默认字符集。下面两行输出分别是编码结果和还原后的原文。
示例
import java.nio.charset.StandardCharsets;
import java.util.Base64;

String source = "Java 8 Base64 文件示例";
String encoded = Base64.getEncoder()
        .encodeToString(source.getBytes(StandardCharsets.UTF_8));
String decoded = new String(
        Base64.getDecoder().decode(encoded),
        StandardCharsets.UTF_8);

System.out.println(encoded);
System.out.println(decoded);

// SmF2YSA4IEJhc2U2NCDmlofku7bnpLrkvos=
// Java 8 Base64 文件示例生成无填充的 URL 安全值
使用 getUrlEncoder,而不是自己替换加号与斜杠。只有接收协议明确允许时才调用 withoutPadding,JWT 就属于这种场景。
示例
String token = Base64.getUrlEncoder()
        .withoutPadding()
        .encodeToString("ÿ?".getBytes(StandardCharsets.UTF_8));

System.out.println(token);
// w78_读写小文件
测试附件和小型文件可以使用 Files.readAllBytes。编码后的 .b64 文件是 ASCII 文本,还原后的 PDF 应与原始二进制逐字节一致。
示例
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.util.Arrays;
import java.util.Base64;

Path source = Paths.get("report.pdf");
Path encodedFile = Paths.get("report.pdf.b64");
Path restored = Paths.get("report-restored.pdf");

byte[] original = Files.readAllBytes(source);
byte[] encoded = Base64.getEncoder().encode(original);
Files.write(encodedFile, encoded);

byte[] decoded = Base64.getDecoder().decode(Files.readAllBytes(encodedFile));
Files.write(restored, decoded);

System.out.println(Arrays.equals(original, decoded));
// true大文件必须使用流
Base64 体积大约增加三分之一。大文件同时保留原字节和编码结果会明显占用内存,应该包装输入输出流,让复制过程维持固定缓冲区。
示例
import java.io.InputStream;
import java.io.OutputStream;
import java.nio.file.Files;
import java.nio.file.StandardCopyOption;

try (OutputStream output = Base64.getEncoder().wrap(
        Files.newOutputStream(encodedFile))) {
    Files.copy(source, output);
}

try (InputStream input = Base64.getDecoder().wrap(
        Files.newInputStream(encodedFile))) {
    Files.copy(input, restored, StandardCopyOption.REPLACE_EXISTING);
}明确处理解码失败
标准解码器会拒绝 URL 安全字符、错误补位和无关字符。URL 输入使用 getUrlDecoder,只有合法 MIME 正文才使用 getMimeDecoder;签名或安全数据不要通过删除字符的方式“修好”。
示例
try {
    byte[] bytes = Base64.getDecoder().decode(value);
} catch (IllegalArgumentException exception) {
    System.err.println("Invalid standard Base64: " + exception.getMessage());
}
在浏览器工具中复核 Java 输出
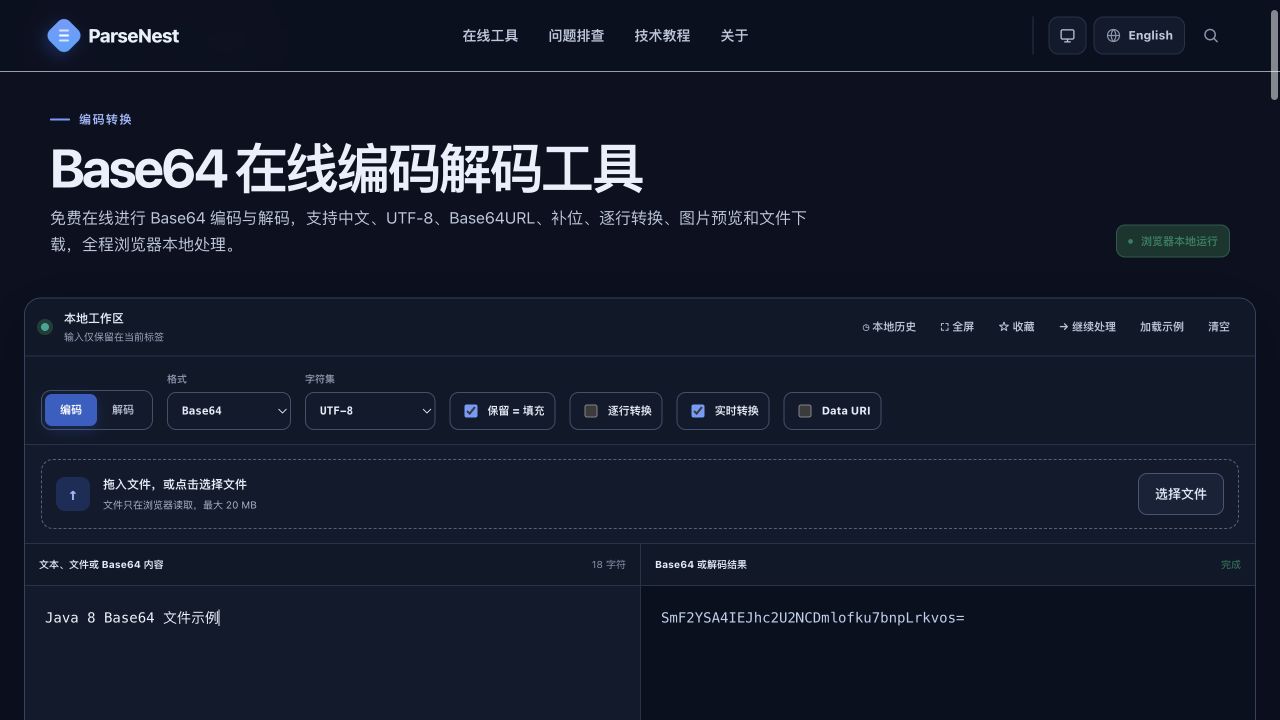
截图结果与第一段 Java 8 代码逐字符一致,可以在把值写入 API 测试、配置或测试夹具前做一次独立复核。
Java 8 编解码器选择表
| 数据格式 | 编码器 | 解码器 | 适用场景 |
|---|---|---|---|
| 标准 Base64 | getEncoder() | getDecoder() | 文件和紧凑 API 值 |
| Base64URL | getUrlEncoder() | getUrlDecoder() | URL 参数与 JWT 分段 |
| MIME Base64 | getMimeEncoder() | getMimeDecoder() | 允许换行的 MIME 正文 |
| 无填充 URL 值 | getUrlEncoder().withoutPadding() | getUrlDecoder() | 协议明确允许省略填充时 |
Java 8 怎样验证文件完全一致
Files.mismatch 不属于 Java 8,因此生产代码可以比较摘要或逐流比较。下面使用的 SHA-256 与 Arrays.equals 都在 Java 8 API 范围内。
java
import java.security.MessageDigest;
import java.util.Arrays;

MessageDigest sha256 = MessageDigest.getInstance("SHA-256");
byte[] originalHash = sha256.digest(Files.readAllBytes(source));
sha256.reset();
byte[] restoredHash = sha256.digest(Files.readAllBytes(restored));

System.out.println(Arrays.equals(originalHash, restoredHash));
// true
要点总结
- Java 8 使用 java.util.Base64,并始终显式指定 UTF-8。
- 标准、URL 和 MIME 编解码器必须与上游格式匹配。
- 大文件使用流式接口,避免二进制和膨胀后的文本同时占用内存。
- 把 IllegalArgumentException 当成格式错误处理,不要静默删字符修复。